




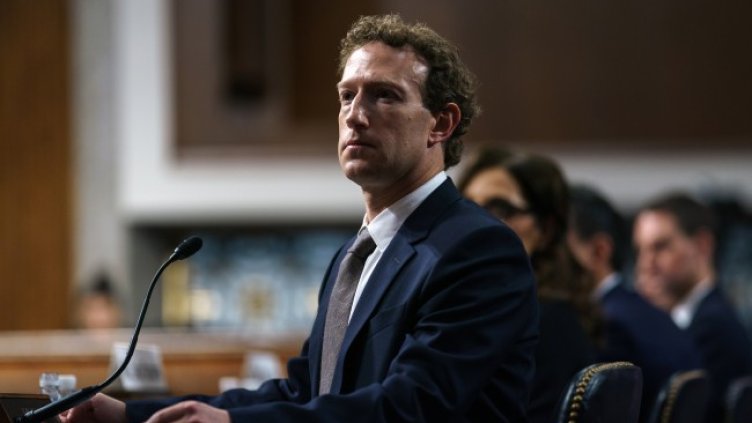
Според последните финансови резултати на Meta Platforms Inc. за много хора Facebook е интернет, а броят на потребителите му продължава да расте. Но Марк Зукърбърг не само празнува този непрекъснат растеж. Той иска да се възползва от него, като използва данните от Facebook и Instagram за създаване на мощен изкуствен интелект с общо предназначение. Звучи чудесно и Meta е добре позиционирана да го направи, но милиардите му потребители в крайна сметка може да платят цената с личните си данни и не само.
Ето как Зукърбърг подсказа следващия си ход в областта на изкуствения интелект в четвъртък:
"Във Facebook и Instagram има стотици милиарди публично споделени изображения и десетки милиарди публични видеоклипове, които според нашите оценки са повече от масива от данни на Common Crawl, а хората споделят и голям брой публични текстови публикации в коментари в нашите услуги."
Въпросът, който Зукърбърг прави тук за "Common Crawl", изненадва наблюдателите в технологичната преса, защото този архив вече е огромен: 250 милиарда уеб страници за период от 17 години. Това е едно от най-големите и популярни хранилища на публичния интернет, което днес се използва за обучение на системи за изкуствен интелект. Когато OpenAI стартира своя езиков модел GPT-3 през 2020 г., близо 60% от текста, използван за обучение на системата, идваше от Common Crawl.
Но планината от данни на Meta е още по-голяма, което означава, че теоретично тя може да създаде "по-интелигентен" ИИ. Това е така, защото изследванията показват, че обучението на моделите на ИИ върху повече данни ги прави по-способни и точни. Тази формула е свършила чудеса за OpenAI, която през годините е увеличила количеството данни, използвани за създаване на модели като ChatGPT.
Ако Зукърбърг иска да създаде по-мощен чатбот, купчината данни, върху които седи, е особено ценна, защото голяма част от тях идват от теми за коментари. Всеки текст, който представлява човешки диалог, е от решаващо значение за обучението на т.нар. разговорни агенти, поради което OpenAI усилено експлоатира интернет форума Reddit Inc. за създаването на свой собствен популярен чатбот.
Лесно е да се подиграваме, когато Зукърбърг говори за нова амбиция - независимо дали става дума за ботове, крипто или метавселена. Най-новата му амбициозна визия е особено голяма: да създаде "общ интелект" или софтуерни системи, които да достигнат или надминат човешкия интелект. Но с всички тези данни стремежът на Зукърбърг изглежда осъществим. Проблемът е какви ще са последиците за останалите.
Странно е, че в същото съобщение, в което Зукърбърг казва, че екипът му за изкуствен интелект работи по изграждането на общ интелект "повече от десетилетие", той казва също, че Facebook едва сега ще се обърне към данните на своите потребители, за да изгради модели като "следващата ключова част от нашия наръчник". Защо Мета вече не го е направила? Може би защото използването на всички тези данни не е толкова просто. От една страна, това би представлявало още едно нарушение на неприкосновеността на личния живот на 3 млрд. потребители на Facebook и 1,5 млрд. потребители на Instagram. По същия начин, по който OpenAI беше подложена на критики за това, че е използвала защитените с авторски права данни на художници и писатели, за да обучава своите модели, Facebook може да се сблъска с негативни последици за репутацията си, ако отново използва данните на хората. Това не само повдига сложни етични въпроси, но и може да изисква строги практики за обработка на данни и спазване на глобалните закони за защита на данните, което може да предизвика недоволството на европейските регулатори.
Другият проблем е свързан с предубедеността и токсичността на данните. Според проучване на Университета в Монреал от 2021 г. OpenAI трябваше да се справи с този проблем при Common Crawl, чийто огромен масив включваше уебстраници за възрастни. В същото проучване се казва, че между 4 и 6% от всички уебсайтове в Common Crawl са включвали расови обиди, реч на омразата или конспиративни теории на расова основа.
Макар че софтуерът за модериране на съдържанието на Facebook е станал по-добър в блокирането на речта на омразата и конспиративните теории, той не е съвършен и има тенденция да се влошава в страни извън САЩ. Част от съдържанието във Facebook, което се маркира като токсично, вече не се преглежда от човек и остава на сайта. Още по-лошо: Когато Зукърбърг каза, че данните на Meta са по-големи от тези на Common Crawl, той вероятно е включил историческия архив на компанията, който ще включва цялото хиперболично политическо съдържание и фалшиви новини, които са били на сайта, преди Зукърбърг да се погрижи да ги изчисти.
Цялата работа, която трябва да се извърши при внимателното обработване и проверка на данните, може да обясни защо Зукърбърг едва сега заговори за капитализиране на планината от данни, върху която се намира. Ако не го направи както трябва, той рискува да преживее кошмара на публичните критики за това как Facebook се справя с фалшивите новини и вредното съдържание.
Все пак, ако има нещо, което знаем за Зукърбърг, то е, че той има мания за победа и доминация, подобна на тази на Цезар. Миналата седмица, около 24 часа след като се изправи пред тълпа от родители във Вашингтон, които го обвиниха, че води децата им към самонараняване или дори самоубийство, той обяви едно от най-успешните финансови тримесечия на Meta и се закани как ще използва данните на хората, за да създаде мощен изкуствен интелект.
Близостта на тези събития трябва да напомня: Пътят на Facebook към богатството е наранил мнозина. Това може да се случи и по пътя му към създаването на мощен изкуствен интелект.
Анализът на Парми Олсън е публикуван на сайта на Bloomberg TV Bulgaria. Тя е колумнист на Bloomberg, който пише за технологиите. Бивш репортер на Wall Street Journal и Forbes, тя е автор на книгата "Ние сме анонимни".
Това се случи Dnes, за важното през деня ни последвайте и в Google News Showcase.
 Кадър на деня за 13 октомври
 ЕС отвори два нови преговорни клъстера с Украйна след оттеглянето на унгарското вето
 S&P 500 затвори почти без промяна след отчетите на големите банки
 Анализатор: Само при голямо изсипване на дизел на пазарите цената може да намалее
 Helena Bioinformatics се стреми да задържи обработката на геномни данни в България
 Apple предизвиква Amazon на пазара за умни домове с новото си устройство HomeView
 "Атлетико" (Мадрид) повали "Манчестър Юнайтед" с 2:0 в Шампионската лига
 Времето днес, 14 октомври: Дъжд и облаци с температури до 16 градуса
 Петковден е! Традиции, обичаи и забрани на 14 октомври 2026
 Хороскоп за 14 октомври 2026 г.: Интересни новини за Телците, ново начало за Раците
 Изоставени коли без застраховка и технически преглед заемат паркоместа в Плевен
 Опасни пътеки, паднали дървета и пропаднал паваж: Сигнали от Русе и Варна
 Интер и Байерн със сензационни издънки в Шампионска лига, вижте всички резултати
 ФИФА отрече скандална информация за Инфантино
 Зрелищен сблъсък! ПСЖ ще пробва да удължи доминацията си над Ман Сити
 Спортът по телевизията днес, 14 октомври
 Мачовете по телевизията днес, 14 октомври
 Драма лиши Балкан от страхотна победа насред Рим
 Нумерологична прогноза за 14 октомври
 6 здравословни добавки към чашата топло мляко
 Петковден е – времето се "обръща" и студовете започват
 Лимонова паста с мисо и орехи
 Таро карта за 14 октомври, сряда - Десетка чаши
 Дневен хороскоп за 14 октомври, сряда
 Защо апендицитът се диагностицира по-трудно в напреднала възраст?
 Кои са обичайните есенни заболявания при децата?
 По-слаб имунитет след тежка тренировка – мит или реалност?
 Студентите по медицина в София могат да кандидатстват за програма по модела на Станфорд
 ЕМА улеснява провеждането на клиничните проучвания, ще имаме ли по-бърз достъп до медикаменти?
 Кофердамът е тема на дентален научен форум в София
 Жълт код за вятър и дъжд ни очакват днес
 Папа Лъв XIV премина през успешна белодробна операция
 Шофьор на тир и пешеходка пострадаха при две катастрофи в Горнооряховско и Велико Търново
 Йотова: Войната се води от страна на Русия срещу Украйна
 Спасените моряци от потъналия край Крапец кораб пристигнаха във Варна
 Шофьор загина в катастрофа на пътя София-Варна
 продава, Четиристаен апартамент, 84 m2 София, Банишора, 185000 EUR
 продава, Тристаен апартамент, 80 m2 Благоевград, Център, 194000 EUR
 продава, Тристаен апартамент, 110 m2 София, Младост 4, 364000 EUR
 продава, Двустаен апартамент, 69 m2 Варна, Възраждане 1, 127000 EUR
 продава, Къща, 150 m2 Варна, Възраждане 3, 300000 EUR
 продава, Магазин, 39 m2 Варна, Колхозен Пазар, 92000 EUR
 Времето днес, 14 октомври: Дъжд и облаци с температури до 16 градуса
 Как да решим проблема с контрола в съвременния свят?
 Какво готви Zeekr за България?
 Най-драстичните трансформации в Холивуд: От шокиращото отслабване на Крисчън Бейл до 10 часа грим за Джейкъб Елорди
 4 зодии, с които е най-приятно да пътувате